Ein Sprachmodell kennt nur, was es beim Training gesehen hat. Retrieval-Augmented Generation ist die Brücke zu allem, was danach entstanden ist — von Wartungsprotokollen bis zu Laborlogbüchern.
Drei Wege, wie Unternehmen KI heute einsetzen
Bevor wir in die Technik einsteigen, lohnt sich ein Schritt zurück. "KI einsetzen" ist keine einzelne Sache — es gibt grundsätzlich drei unterschiedliche Muster, und sie lösen unterschiedliche Probleme.
|
Prompting / Agnostisch Eine direkte Anfrage an ein LLM — ohne Zugriff auf externe Datenquellen. Das Modell antwortet ausschließlich aus dem, was es beim Training gelernt hat. Schnell, aber blind gegenüber allem, was firmenintern ist. |
|
RAG Das LLM bekommt zur Anfragezeit relevantes, aktuelles Wissen aus einer externen Quelle "gereicht" — typischerweise über eine Vektor-Datenbank. Das Modell antwortet fundiert, nicht aus Erinnerung. |
|
Agentic AI Das System bleibt nicht bei einer Antwort stehen — es handelt. Es ruft Tools auf, löst mehrstufige Aufgaben eigenständig und trifft Zwischenentscheidungen, oft unter Einbindung von RAG. |
|
💡 FOKUS DIESES ARTIKELS Alle drei Ansätze schließen sich nicht gegenseitig aus. Dieser Artikel konzentriert sich bewusst auf RAG, weil es der Ansatz ist, der für die meisten Unternehmen den größten Hebel bietet: bestehendes Wissen nutzbar machen, ohne ein Modell neu zu trainieren. |
Was sind Vektordatenbanken?
Eine Vektor-Datenbank speichert Inhalte nicht als Zahlen, Text oder Tabellenzeilen, sondern als Vektoren — lange Listen von Zahlen, die die Bedeutung eines Inhalts repräsentieren. Diese Vektoren nennt man Embeddings. Ein Embedding-Modell wandelt Text, Bilder oder Audio in genau so einen Vektor um.
Der entscheidende Effekt: Inhalte mit ähnlicher Bedeutung erzeugen Vektoren, die im Zahlenraum nah beieinander liegen — unabhängig davon, ob die exakten Wörter übereinstimmen. "Die Maschine fällt aus" und "Störung der Anlage" verwenden völlig unterschiedliche Wörter, meinen aber dasselbe. Für eine klassische Suche sind das zwei fremde Zeichenketten. Für eine Vektor-Datenbank liegen sie nebeneinander.
Vektor-Datenbanken im Vergleich zu SQL und NoSQL
SQL- und NoSQL-Datenbanken sind exzellent, wenn Sie wissen, wonach Sie suchen — eine ID, ein exakter Feldwert, ein Schlüssel. Eine Vektor-Datenbank ist dafür gebaut, wenn Sie thematisch oder inhaltlich suchen, ohne die exakten Begriffe zu kennen.
|
Kriterium |
SQL-Datenbank |
NoSQL |
Vektor-Datenbank |
|
Sucht nach |
Exakten Werten, Bedingungen |
Schlüsseln, Struktur |
Bedeutungsähnlichkeit |
|
Typische Abfrage |
"Kunde-ID = 123" |
"Dokument mit ID abc" |
"Was ist inhaltlich am nächsten?" |
|
Versteht Synonyme |
Nein |
Nein |
Ja |
|
Stärke |
Präzise, transaktional |
Flexibel, unstrukturiert |
Semantische Suche |
Warum braucht ein LLM eine Vektor-Datenbank — und keine SQL- oder NoSQL-Datenbank?
Ein Servicetechniker fragt: "Was mache ich, wenn die Anlage ausfällt?" — im Handbuch steht aber: "Bei Störung der Anlage greift der Notfallplan." Eine SQL-Abfrage mit LIKE '%ausfällt%' findet nichts, weil das Wort "ausfällt" im Dokument nicht vorkommt. Eine Vektor-Suche erkennt die Bedeutungsnähe und liefert den passenden Abschnitt trotzdem.
Das ist der Kern von RAG: Ein LLM hat kein aktuelles, firmenspezifisches Wissen gespeichert. Es braucht zur Anfragezeit die passenden Textstücke — und dafür braucht es eine Suche, die nach Bedeutung sucht, nicht nach exakten Wörtern.
Wie eine RAG Abfrage abläuft
Der Ablauf folgt immer demselben Muster: Frage einbetten, ähnlichste Wissensabschnitte finden, beides gemeinsam an das LLM übergeben.
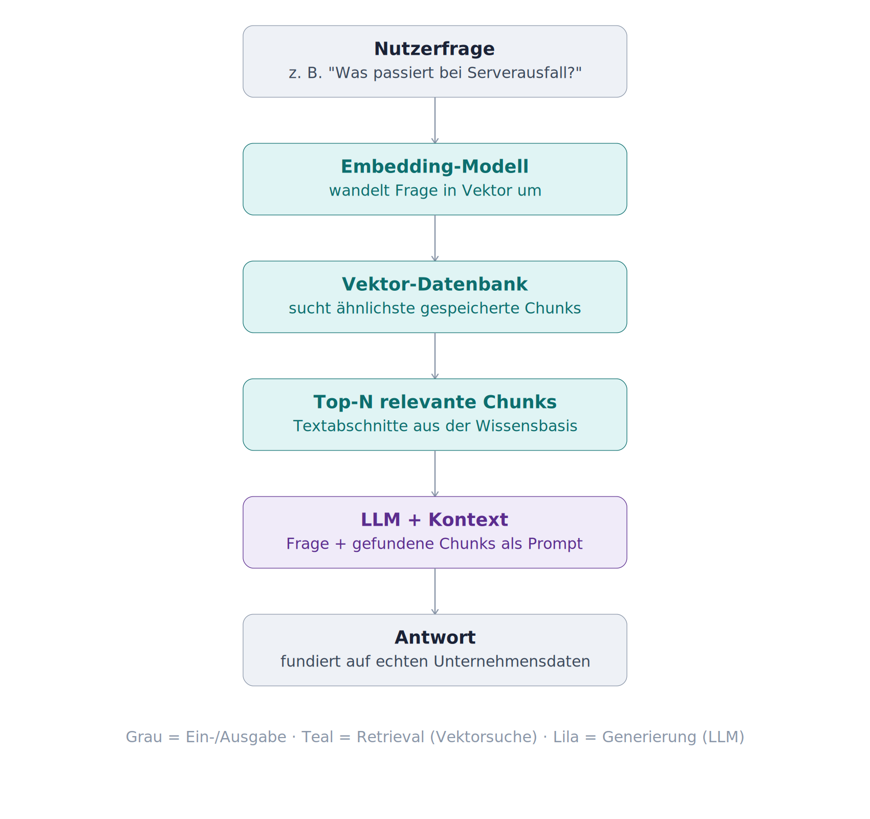
Wichtig dabei: Das LLM "sucht" nicht selbst. Es bekommt den passenden Kontext bereits fertig serviert. Die eigentliche Intelligenz der Suche steckt in Embedding und Vektorsuche — nicht im Sprachmodell.
Was Sie brauchen, um ein RAG System aufzubauen
Datenquellen: die Dokumente, Datenbanken, Wikis oder APIs, aus denen Ihr Wissen kommt.
Chunking-Strategie: Dokumente werden in kleinere Abschnitte zerlegt — man kann kein ganzes Handbuch auf einmal einbetten.
Embedding-Modell: wandelt jeden Abschnitt in einen Vektor um.
Vektor-Datenbank: speichert diese Vektoren und die Originaltexte.
Retrieval-Logik: findet zur Anfragezeit die passendsten Abschnitte.
LLM: formuliert aus Frage und gefundenem Kontext die Antwort.
Aktualisierungsmechanismus: hält die Vektor-Datenbank synchron, wenn sich Dokumente ändern.
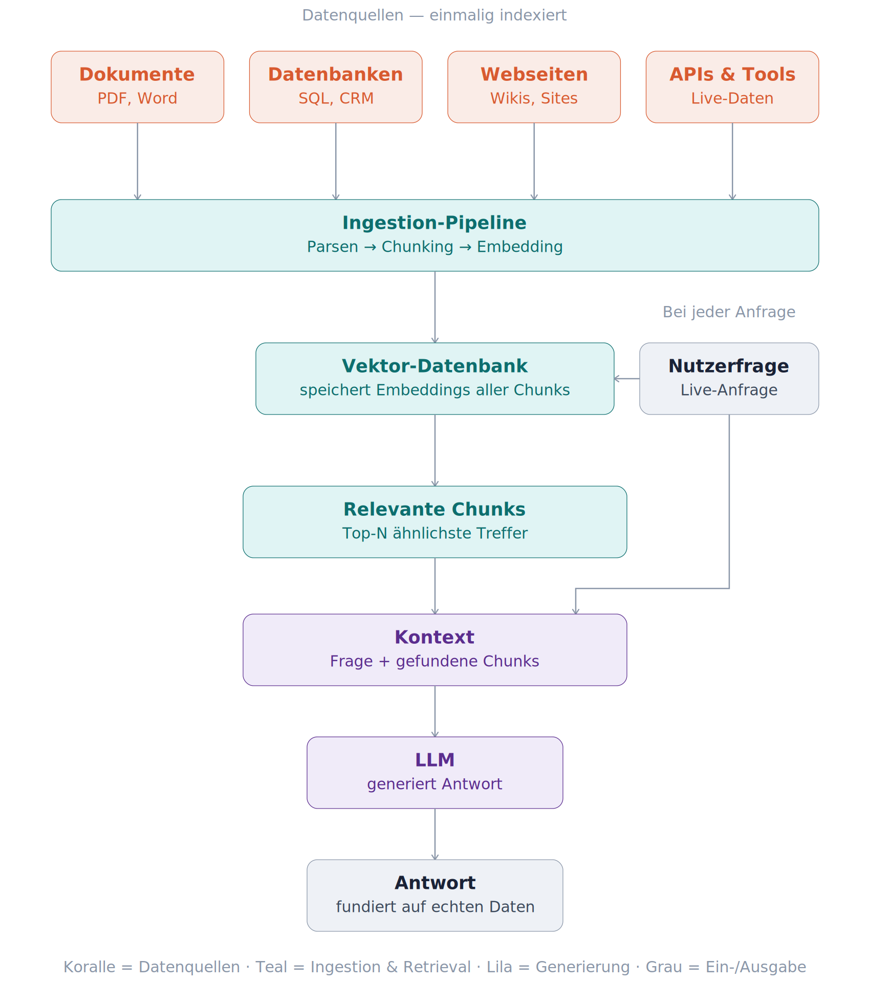
Sobald mehrere Datenquellen im Spiel sind — was im Unternehmensalltag der Regelfall ist — laufen sie alle durch dieselbe Ingestion-Pipeline und landen als vergleichbare Vektoren im selben Speicher:
🔄 PRAKTISCHER HINWEIS
Speichern Sie pro Chunk immer Metadaten wie Quelle und Datum mit. Das erlaubt später Filterung und Antworten mit Quellenangabe. Unterschiedliche Quellentypen ändern sich unterschiedlich schnell und sollten getrennte Aktualisierungszyklen bekommen.
Welche Ein- und Ausgabetools gibt es?
Ein RAG-System besteht nicht aus einem einzelnen Produkt, sondern aus mehreren austauschbaren Bausteinen — auf der Eingabeseite (Daten hinein) und auf der Ausgabeseite (Antworten heraus).
|
Eingabe-Konnektoren Lesen und parsen Rohdaten aus unterschiedlichen Quellen — z. B. LangChain Document Loaders, LlamaIndex Readers, Unstructured.io oder Apache Tika für PDFs, gescannte Dokumente und Web-Inhalte. |
|
Embedding-Modelle Wandeln Text in Vektoren um — z. B. OpenAI text-embedding-3, Cohere Embed, Voyage AI oder offene Modelle wie BGE und E5, die auch lokal betrieben werden können. |
|
Orchestrierungs-Frameworks Verbinden Chunking, Embedding, Retrieval und Generierung zu einer Pipeline — etwa LangChain, LlamaIndex, Haystack oder Microsoft Semantic Kernel. |
|
Sprachmodelle (Ausgabe) Formulieren aus Frage und Kontext die finale Antwort — z. B. Claude, GPT- oder Gemini-Modelle, wahlweise über API, als Chat-Oberfläche oder mit strukturierter JSON-Ausgabe. |
Welche Vektor-Datenbanken gibt es?
Die Auswahl reicht von vollständig verwalteten Cloud-Diensten bis zu Erweiterungen für Datenbanken, die viele Unternehmen bereits im Einsatz haben.
|
Kategorie |
Beispiele |
Besonders geeignet für |
|
Managed / Cloud |
Pinecone, Weaviate Cloud, Qdrant Cloud, Azure AI Search, Vertex AI Vector Search |
Schneller Start ohne eigenen Betrieb |
|
Self-hosted / Open Source |
Milvus, Weaviate, Qdrant, Chroma |
Volle Kontrolle, On-Premise-Betrieb |
|
Erweiterung bestehender DB |
pgvector (PostgreSQL), Redis, Elasticsearch/OpenSearch, MongoDB Atlas |
Vektorsuche ohne neues System |
Welche Variante passt, hängt weniger von der Technologie als von Ihren Rahmenbedingungen ab: Wie viele Dokumente? Muss die Lösung on-premise laufen, etwa aus Compliance-Gründen? Ist bereits eine PostgreSQL-Infrastruktur vorhanden, in die sich pgvector einfach einfügt?
Sind Vektor-Datenbanken getrennt vom LLM zu betrachen?
Ja — und das ist ein wichtiger Punkt für jede KI-Strategie. Ein LLM ist zustandslos: Es hat zwischen zwei Anfragen kein Gedächtnis. Die Vektor-Datenbank ist die externe, persistente Wissensschicht, die dieses fehlende Gedächtnis ersetzt.
Diese Entkopplung hat praktische Vorteile:
Das LLM ist austauschbar, ohne dass Wissen verloren geht — ein Modellwechsel berührt die Vektor-Datenbank nicht.
Die Vektor-Datenbank ist austauschbar, ohne das Sprachmodell zu wechseln.
Kontrolle über die Daten bleibt im Unternehmen: On-Premise-Betrieb der Vektor-Datenbank ist möglich, während das LLM extern angefragt wird — oder umgekehrt.
Anbieter lassen sich frei kombinieren: Embedding-Modell, Vektor-Datenbank und LLM müssen nicht vom selben Hersteller stammen.
📐 ZUR EINORDNUNG
Manche Plattformen bieten einen eingebauten, gehosteten Vektor-Speicher direkt neben dem Sprachmodell an. Das wirkt wie eine untrennbare Einheit — technisch bleiben es aber zwei Komponenten mit unterschiedlichen Aufgaben: Speicherung und Abruf von Wissen auf der einen Seite, Sprachverständnis und -generierung auf der anderen.
RAG im praktischen Einsatz
Theorie ist das eine — der Unterschied zeigt sich dort, wo Wissen über Jahre gewachsen und über viele Formate verstreut ist. Zwei Beispiele aus der Praxis.
Windkraft: 20 Jahre Betriebsdokumentation für Servicetechniker
Ein Windpark-Betreiber verwaltet Anlagen aus über zwei Jahrzehnten, mehreren Herstellern und diversen Baujahren. Die Dokumentation dazu ist entsprechend gewachsen: Papierhandbücher aus den frühen Jahren, PDF-Wartungsberichte, Änderungsmitteilungen, handschriftliche Servicenotizen — verteilt über Aktenordner, Netzlaufwerke und ein Intranet, das kaum noch jemand vollständig durchsucht.
Ein Servicetechniker steht vor Ort an einer Anlage und braucht sofort eine Antwort: "Welches Anzugsdrehmoment gilt für diese Schraubverbindung bei diesem Anlagentyp und Baujahr?" Bisher bedeutete das: Ordner durchsuchen, Kollegen anrufen, im schlechtesten Fall den Servicetermin verschieben.
Mit einem RAG-System wird die gesamte historische Dokumentation — Handbücher, Wartungsprotokolle, Änderungsmitteilungen, eingescannt und per OCR durchsuchbar gemacht — in eine Vektor-Datenbank überführt. Der Techniker stellt seine Frage über ein Tablet direkt vor der Anlage und erhält die passende Antwort inklusive Verweis auf das Originaldokument und die genaue Seite. Sicherheitsrelevant ist dabei entscheidend: Die Antwort zitiert ihre Quelle, statt einfach zu behaupten.
Labor: Gerätedokumentation, Logbücher und Schulungsnachweise
Ein Labor betreibt zahlreiche Analysegeräte — jedes mit eigenem Handbuch, eigenen Kalibrierprotokollen und eigenem Wartungslogbuch, oft handschriftlich geführt und nachträglich gescannt. Hinzu kommen die Schulungsunterlagen: Wer wurde wann auf welchem Gerät eingewiesen, und ist diese Schulung noch gültig?
Eine neue Laborantin fragt: "Wie kalibriere ich Gerät X, und wer im Team ist aktuell dafür geschult?" Ohne strukturierten Zugriff bedeutet das Suchen in mehreren Aktenordnern und Nachfragen bei Kollegen — mit dem Risiko, eine veraltete Version des Protokolls zu erwischen.
Ein RAG-System, das gescannte Handbücher, Logbücher und Schulungsnachweise gemeinsam indexiert, beantwortet solche Fragen direkt und mit Quellenangabe. Der Nebeneffekt: Dieselbe Datenbasis unterstützt auch die Audit-Vorbereitung — genau die Frage, die im Pharma & Legacy-Kontext regelmäßig gestellt wird: "Wie stellen Sie sicher, dass nur geschultes Personal dieses Gerät bedient?"
„Die Dokumentation war immer da. RAG macht sie zum ersten Mal tatsächlich auffindbar.“
Kann RAG auch die Forschung im Labor unterstützen?
Ja — und hier geht der Nutzen über reine Dokumentensuche hinaus. Ein RAG-System kann neben operativer Dokumentation auch wissenschaftliche Literatur, Grundlagenwissen aus Chemie, Biologie und Physik sowie die eigenen, internen Experimentdaten in derselben Wissensbasis zusammenführen — einschließlich der Experimente, die nicht zum gewünschten Ergebnis geführt haben.
Nehmen wir ein konkretes Szenario: Ein Forschungsteam sucht ein Material mit einer vorgegebenen Ziel-Eigenschaftskombination — etwa einer bestimmten thermischen Leitfähigkeit bei gleichzeitiger Korrosionsbeständigkeit. Der klassische Weg bedeutet Wochen der Literaturrecherche: Hunderte Publikationen sichten, mit internen Laborergebnissen abgleichen, Muster von Hand erkennen.
Mit RAG wird dieselbe Frage gegen eine Wissensbasis aus drei Schichten gestellt: öffentliche wissenschaftliche Publikationen, interne Grundlagen- und Methodenskripte, und die komplette interne Experimenthistorie. Das System liefert kontextuelle Vorschläge, die Materialklassen aus der Literatur mit Hinweisen aus früheren — auch gescheiterten — eigenen Experimenten verknüpfen, in denen ähnliche Eigenschaften bereits beobachtet wurden.
Der Effekt: Forschungszyklen verkürzen sich, weil Hypothesen schneller und fundierter entstehen, bereits gescheiterte Experimente nicht unwissentlich wiederholt werden, und Wissen aus mehreren Fachdisziplinen zusammengeführt wird, das ein einzelner Forscher kaum vollständig überblicken kann.
⚗️ WICHTIGE EINORDNUNG
RAG ersetzt kein Experiment und keine wissenschaftliche Bewertung. Es liefert bessere, breiter fundierte Ausgangshypothesen — die Entscheidung, welcher Ansatz tatsächlich verfolgt wird, trifft weiterhin das Forschungsteam.
Fazit: Das Fundament ist die Wissensbasis, nicht das Modell
RAG löst ein sehr konkretes Problem: Ein Sprachmodell allein kennt Ihr Unternehmen nicht. Erst die Verbindung mit einer strukturierten, durchsuchbaren Wissensbasis macht es zu einem Werkzeug, das mit Ihren echten Daten arbeitet — ob Wartungsprotokoll, Laborlogbuch oder Forschungsdatenbank.
Die Technologie dahinter — Embeddings, Vektor-Datenbanken, Retrieval — ist austauschbar und wird es auch bleiben. Der eigentliche Wert entsteht durch die saubere Aufbereitung der eigenen Wissensbasis.
Wie steht es um die Wissensbasis in Ihrem Unternehmen?